 Varazdat S.
 Janis Tirtey
結論
目標は同じ、方法が違う
どのAIインフルエンサーツールも、同じことを約束しています。何百もの投稿にわたって、同じ顔が変わらず残るということです。その約束の裏で、主要プラットフォームはかなり異なる仕組みで動いています。どの方法を使うかによって、どれだけ手間がかかるか、そして顔のどこがズレうるかが決まります。
要点として、2026年10月10日時点では、Higgsfieldは「Soul ID」と呼ばれるアイデンティティを、一人の人物の20枚以上の写真で学習させます。OpenArtは、参照画像、テキストプロンプト、またはキャラクタービルダーからキャラクターを保存し、再利用できるようにします。LeonardoとMidjourneyは、1枚の参照画像で新しい画像のひとつひとつを誘導します。RYLAは、ガイド付きのビルダーで新しいキャラクターを一度デザインし、そのキャラクターから以降のすべての画像を生成します。
このページでは、各社が自社の製品について公開している情報だけを使って方法を比べます。画像の品質は評価しません。品質はプロンプト、モデル、シーンによって変わるからです。RYLAは、Higgsfield、OpenArt、Leonardo、Midjourneyと提携しておらず、それらの支持を受けておらず、いかなる関係もありません。それらの名前は、各サービスを特定するためだけに使っています。
顔を保つ3つの方法
学習、保存したキャラクター、単一の参照
画像生成モデルは、生成と生成の間に記憶を持ちません。そのため各ツールは、顔を画像から画像へ運ぶための仕組みを上に重ねています。よく使われるアプローチは次の3つです。
- 多くの写真でアイデンティティを学習させる。 ひとりの人物の写真セットをアップロードすると、プラットフォームが数分かけてそれを学習します。以後は、生成のたびにそのアイデンティティを選べます。事前の手間は多くなりますが、後の繰り返しは少なくなります。
- 再利用できるキャラクターを保存する。 画像、プロンプト、またはビルダーから一度キャラクターを作ると、プラットフォームがそれを保存します。毎回顔を文章で説明する代わりに、そのキャラクターを選び直せます。
- 1枚の参照画像で画像ごとに誘導する。 どのプロンプトにも1枚の画像を添付し、どの程度忠実に従わせるかを設定します。すぐに始められますが、参照は画像ごとに適用されるため、強すぎる設定では、変えたかった髪型、服、ポーズまで写ってしまうことがあります。
この技術の土台にある仕組み(シード、LoRA学習、アイデンティティアダプター、顔の差し替え)を詳しく知りたい場合は、AI インフルエンサーの一貫性を参照してください。
プラットフォームの比較表
各ベンダーが自社の方法について述べていること
この表の内容はすべて、2026年10月10日に読んだ各ベンダー自身のヘルプページとドキュメントに基づいています。これは各社の発表であり、第三者による検証ではありません。
| プラットフォーム | 方法 | 必要なもの | ベンダーが示す制限 |
|---|---|---|---|
| Higgsfield(Soul ID) | アイデンティティを学習 | 同じ人物の写真20枚以上、最大80枚 | 本人または許可を得た人物のみアップロードすること。架空のキャラクターの場合は、まずポートレートを生成し、それで学習させること |
| OpenArt(Characters) | 保存して再利用できるキャラクター | 参照画像、テキストプロンプト、またはビルダーのプリセット | 小さなばらつきが出る場合がある |
| Leonardo(Character Reference) | 画像ごとに1つの参照 | 単一の参照画像、強度はLowからHighまで設定 | 一度に1枚のみ。外部の写真より生成された被写体で良く働く |
| Midjourney(Omni Reference) | 画像ごとに1つの参照 | 参照画像とテキストプロンプト | 標準のV7画像の2倍のGPU時間を使用。インペインティングとアウトペインティングには使えない |
| RYLA | 参照シート付きのデザイン済みキャラクター | ガイド付きビルダーでの選択 | 写真セットで学習させるのではなく、新しいキャラクターをデザインするために作られている |
他社が優れている点: 既存の実在の人物(自分自身、自分の写真)の顔が必要な場合は、Higgsfield Soul IDがまさにその用途のために作られています。一方、RYLAのビルダーは新しいキャラクターのデザインに向いています。手元の画像からルックを借りたい場合は、LeonardoとMidjourneyの参照機能のほうが素早く始められます。
プラットフォームごとの詳細
表の背景にある詳細
Higgsfield Soul ID。 Higgsfieldのヘルプセンターは、同じ人物の写真を20枚以上求め、最大80枚まで対応すると述べています。学習には数分かかるとも書かれています。ヘルプセンターによると、学習済みのSoul IDはSoulモデルファミリー全体で機能し、Seedanceの動画生成にElementとして持ち込めます。また、アップロードしてよいのは本人または許可を得た人物だけであること、そして架空のキャラクターは、まずポートレートを生成してから学習させるべきであることも書かれています。直接比較したい場合は、RYLA と Higgsfield の比較を参照してください。
OpenArt Characters。 OpenArtのキャラクターページでは、キャラクターを作る3つの方法が説明されています。参照画像、テキストプロンプト、またはキャラクタービルダーのプリセットです。参照画像は顔の構造を最も細かく制御できるとされています。保存したキャラクターは複数の生成で再利用できると書かれており、FAQには、小さなばらつきが出る場合があるものの、独立した生成と比べると一貫性は大きく向上すると添えられています。あわせて OpenArt の代替も参照してください。
Leonardo Character Reference。 Leonardoのヘルプセンターによると、Character Referenceは1枚の参照画像にある被写体の見た目を参照しながら画像を生成します。一度に使えるのは1枚だけで、強度はLowからHighまで調整できます。外部の被写体よりも、生成された被写体で良く機能するとも書かれています。
Midjourney Omni Reference。 Midjourneyのドキュメントでは、Omni Referenceを、参照画像にあるキャラクター、オブジェクト、乗り物、生き物を新しい画像に持ち込む方法として説明しています。コストは標準のV7画像の2倍のGPU時間で、インペインティングとアウトペインティングには対応していないとされています。
一貫性を自分で確かめる
契約前に行う短いチェック
マーケティングページは、いずれも最も良い結果だけを見せています。そこで、検討しているどのプラットフォームでも、同じ小さなテストを行ってください。
- キャラクターの参照画像を1枚作って保存します。 以後のすべての画像は、この画像と照らし合わせて評価されます。
- 10枚の画像を生成します。 ポーズ、服装、ライティング、背景、カメラの距離など、一度に1つずつ変えてください。
- 各画像を、直前の画像ではなく参照画像と比べます。 目、鼻の形、顎のライン、生え際を確認してください。
- そのうち、編集せずに投稿したい枚数を数えます。 この数字は、自分のプロンプトで得られたものであり、どんな機能一覧よりも多くのことを教えてくれます。
- 動画や話すクリップを作ってみます。 動画を投稿する予定がある場合は、同じキャラクターでそれを試してください。動きは、静止画では隠れているズレを明らかにするからです。
写真の一括制作のより詳しい手順は、複数の写真でAI キャラクターの一貫性を保つ方法にまとめています。
RYLAでの方法
ビルダーでの実際の流れ
RYLAのビルダーは、写真セットで学習させるのではなく、デザインの選択から始まります。また、毎回のプロンプトで参照画像を求めることもありません。新しいキャラクターを一度デザインすると、以後のすべての生成はそのキャラクターから始まります。RYLAのビルダーでの実際の流れは次のとおりです。
- ニッチを選び、次に性別とスタイルを選びます。
- 見た目を設定します。民族的特徴、年齢、肌、目、顔の形、髪型です。
- 衣装とシーンを選び、次に性格と名前、最後に声を選びます。
- ベース画像を生成し、キャラクターになるものを1枚選びます。
- RYLAが、その顔の参照シートを作成します。
- 仕上げると、Studioで新しい写真を作成し、画像から動画で動きを付け、Avatar Videoで話すクリップを作り、Video Swapで差し替えができます。
このサイトのショーケースにある、RYLAのキャラクターを2つの異なるシーンで生成した例です。
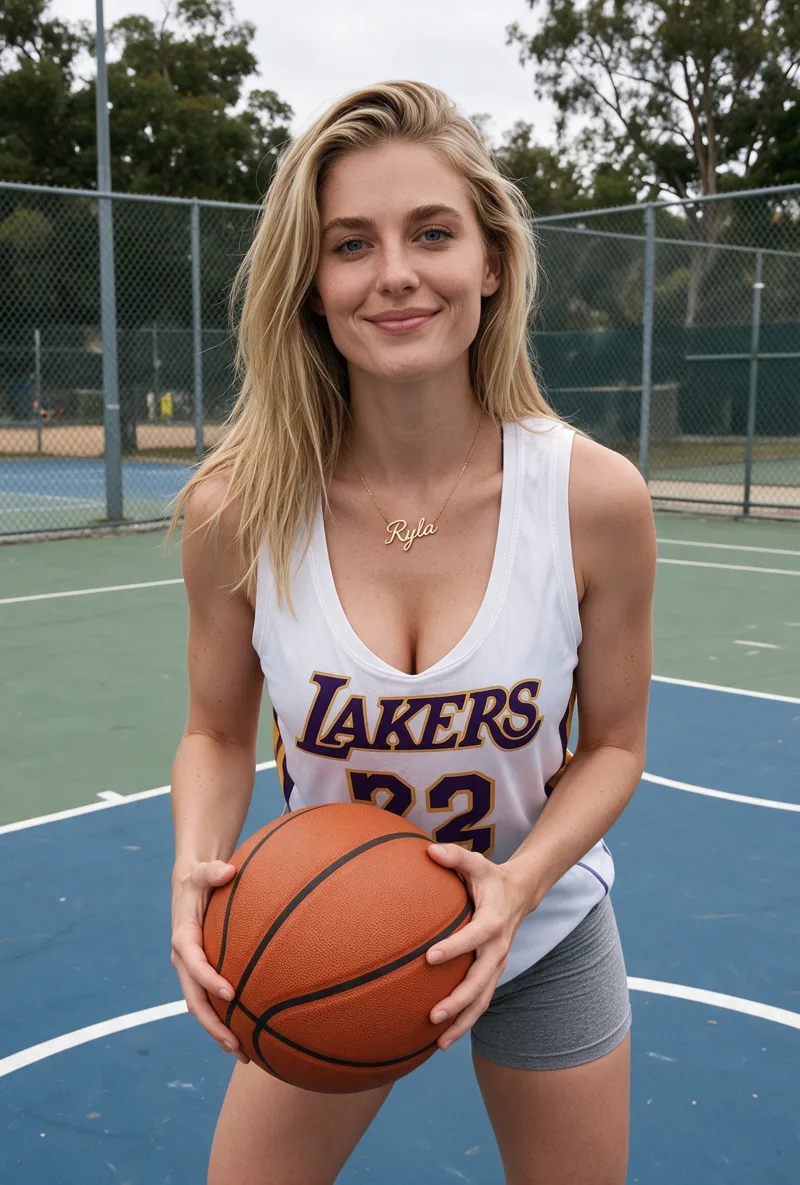
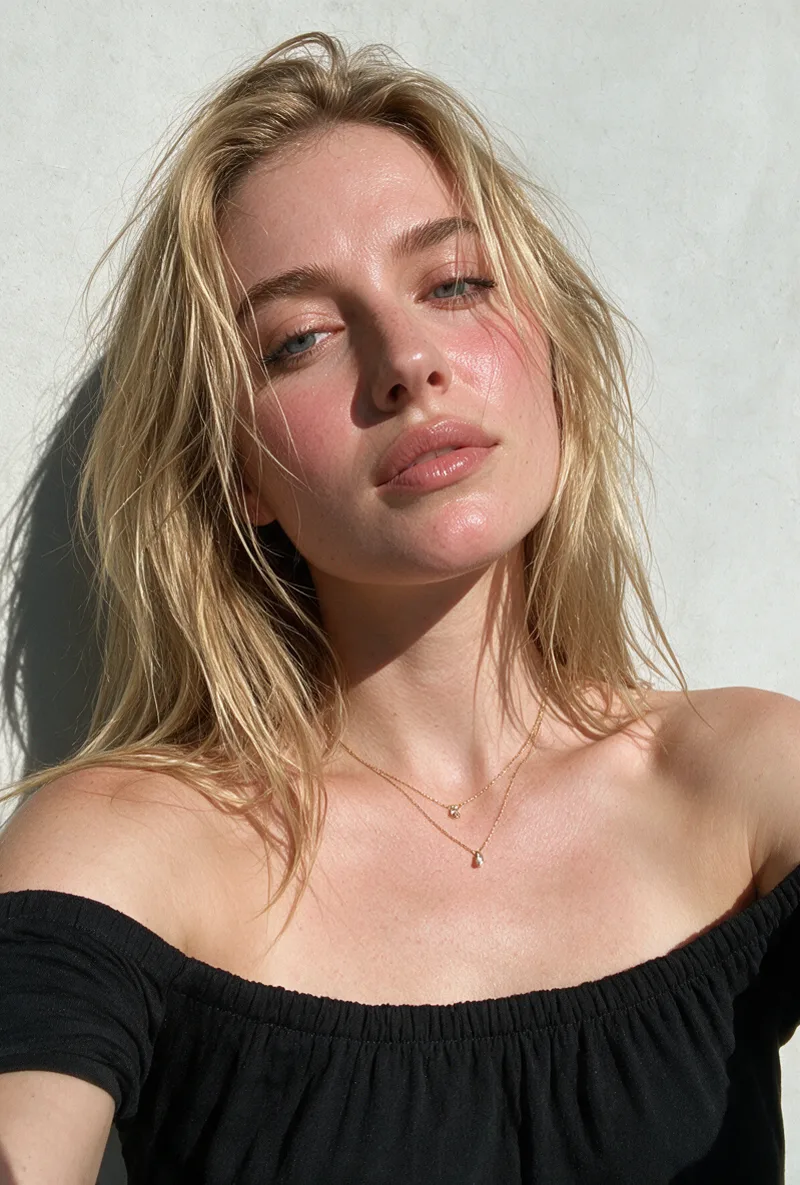
プランとクレジットは料金ページにあります。キャラクターを始めるには、AI インフルエンサーを作成するを参照してください。
Design One Character, Then Generate It Everywhere
Build a new AI character in the RYLA builder and create its photos, video and talking clips from the same reference sheet.
無料トライアルを開始自分のプロジェクトに合うのは
目的に合わせて方法を選ぶ
- 自分の顔を、自分の写真から使いたい場合: Higgsfield Soul IDのように、多くの写真で学習させたアイデンティティが、その用途にそのまま合います。
- 単発の画像を作り、手元の画像からルックを借りたい場合: Leonardo Character ReferenceやMidjourney Omni Referenceのような単一参照のツールが、最も素早く始められます。
- 汎用の画像スタジオの中で再利用できるキャラクターが欲しい場合: OpenArt Charactersのような保存済みキャラクターが、複数の生成にわたって選び続けられるようにします。
- 写真、動画、話すクリップを投稿する、まったく新しいAI インフルエンサーが欲しい場合: RYLAのように、参照シート付きのデザイン済みキャラクターを使えば、コンテンツ制作の全体を同じ顔に結び付けられます。
動画、料金、使いやすさまで含めたより広い比較は、AI インフルエンサープラットフォームの比較を参照してください。
出典
すべての出典は2026-10-10に取得
- Higgsfield ヘルプセンター、Soul ID キャラクターの作成と利用(2026年10月10日に閲覧)
- OpenArt、Characters(2026年10月10日に閲覧)
- Leonardo ヘルプセンター、Image Guidance(2026年10月10日に閲覧)
- Leonardo API ドキュメント、Image Guidance を使った画像生成(2026年10月10日に閲覧)
- Midjourney ドキュメント、Omni Reference(2026年10月10日に閲覧)